# def plot_array(plt, shape=(1, 10), figsize=None, cmap='viridis', a=None):
#     colors = ('black', 'white')
#     if a is None:
#         array = np.linspace(0, 10, shape[0] * shape[1]).reshape(shape)
#     else:
#         array = a
#     if figsize is None:
#         figsize = shape
#     plt.figure(figsize=figsize)
# #     cmap = colors.ListedColormap(['blue'])
#     plt.imshow(array, cmap=cmap)
# #     if len(shape) == 2:
# #         if shape[0] == 1:
# #             gen = (i for i in range(shape[1]))
# #         else:
# #             gen = ("{}".format(i * shape[1] + j)
# #                    for i in range(shape[0])
# #                    for j in range(shape[1]))
# #         for i, j in ((i, j) for i in range(shape[0]) for j in range(shape[1])):
# #             plt.text(j, i, gen.send(None), ha='center', va='center',
# #                      size=15 if shape[0] != 1 else 20,
# #                      color=colors[1 if array[i, j] < 5 else 0])
# #     else:
# #         raise ValueError('Only support for 1/2-d array')
#     plt.axis('off')
#     #plt.title("{}-d array with shape {}".format(1 if array.shape[0] ==1 else 2,
#     #                                                          array.shape))


def download_img(filename):
    import re
    import os
    import requests
    url_pattern = re.compile(r'''(?x)
                            .*src=\\"(.*?)\\" .* #src=\"url\"
                            | .*(https:.*(?:png|jpeg)).*       #https:
                            | .*(http:.*(?:png|jpeg)).*''')    #http:
    img_name_pattern = re.compile(r'''(?x)
                            .*/(.*.png).*
                            |.*/(.*.jpeg).*''')
    with open(filename, 'r', encoding='utf-8') as f:
        for i in  re.finditer(url_pattern, ''.join(f.readlines())):
            url = [url for url in i.groups() if url][0]
            if len(url) < 25:
                continue
            image_name = [ name for name in re.match(img_name_pattern, url).groups()  if name][0]
            if not os.path.isfile(image_name, ):
                try:
                    response = requests.request("get", url)
                    with open(image_name, 'wb') as img:
                        img.write(response.content)
                except:
                    print(url, image_name)

def plot_linspace(a1,  a2, num, figsize=(5, 2)):
    plt.figure(figsize=figsize)
    plt.plot(a2, np.zeros(num) - 0.1, 'o')
    plt.plot(a1, np.zeros(num) + 0.1, 'o')
    plt.ylim([-0.2, +0.2])
    plt.yticks([])
from matplotlib import colors
import numpy as np
import matplotlib.pyplot as plt
from IPython.core.interactiveshell import InteractiveShell
InteractiveShell.ast_node_interactivity = "all"
一. 用 Numpy 做矩阵运算
Numpy是一个支持多维数组、矩阵快速运算的科学计算包,其自带众多针对数组运算的数学函数,极大的简化了向量和矩阵的操作。正因为如此,众多软件包使用Numpy作为其基础构架,比如scipy, pandas, scikit-learn,matplotlib等科学计算、数据科学和绘图库。numpy以及这些依赖numpy的软件包,形成了一个强大的科学计算环境。
1. numpy.ndarray 对象
ndarray是numpy的基本对象,用于存储一个元素数据类型相同,元素数量固定的多维数组。 我们先来看看ndarray大致形状以及其表现形式:
一维数组:用于表示一个一维的序列。时间序列就是一维的,该序列中的每个元素对应不同时刻下的值(信号强度,音频信号,股票价格等)。并且一维数组和list非常相似,都可以对他们进行索引,切片和迭代。

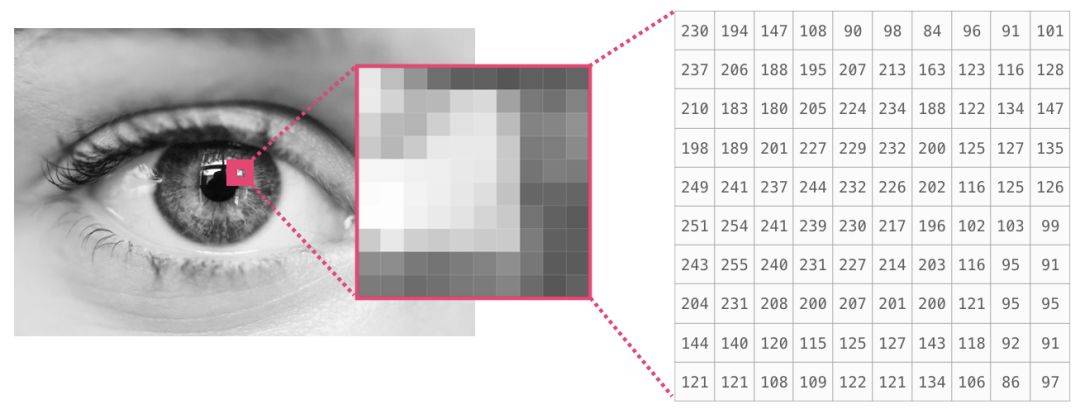
二维数组:类似于我们数学中的矩阵,拥有两个维度。一张黑白图像就是二维的(高度x宽度),图片中的每个像素可以用单个数字来表示(0为黑色, 255为白色)。
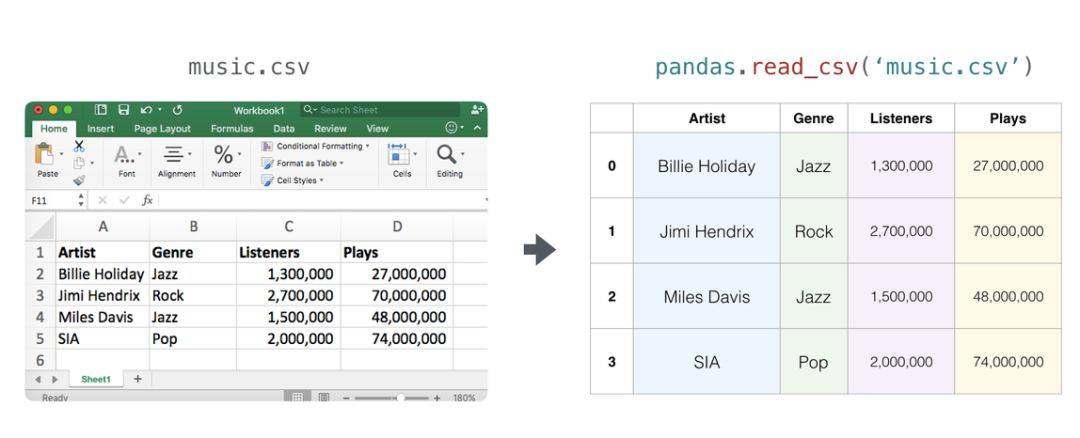
再比如日常生活中使用的电子表格,也拥有行与列两个维度,所以可以使用二维的ndarray进行表示。(pandas就是干这个的, 并且pandas也是在numpy的ndarray基础上构建的)
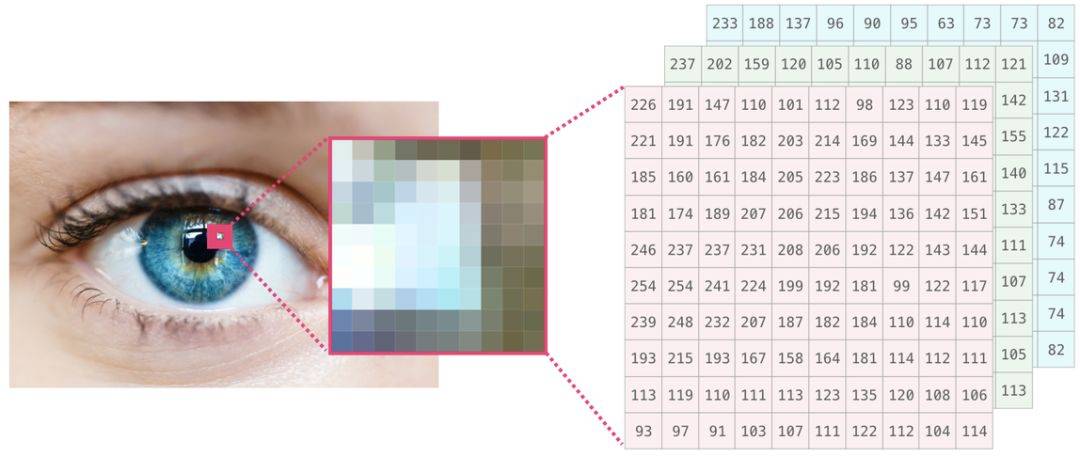
多维数组:拥有多个维度。上图为黑白图像,其灰度只需要用一个数字(0-255)就可以进行表示,所以可以用一个二维数组来表示;我们知道一张彩色图片的每个像素点的颜色可以用RGB来表示-红、绿、蓝。因此,我们的数据是三维的(高度x宽度x3),需要用一个三维数组来表示。更一般的,还可以拓展到更多维的情况。
1.1 ndarray 对象的基本属性:
有了上面的抽象表示,我们来看看ndarray这个类的对象具有哪些基本属性,通过一个对象的基本属性,可以大致的了解一个对象具有哪些性质。
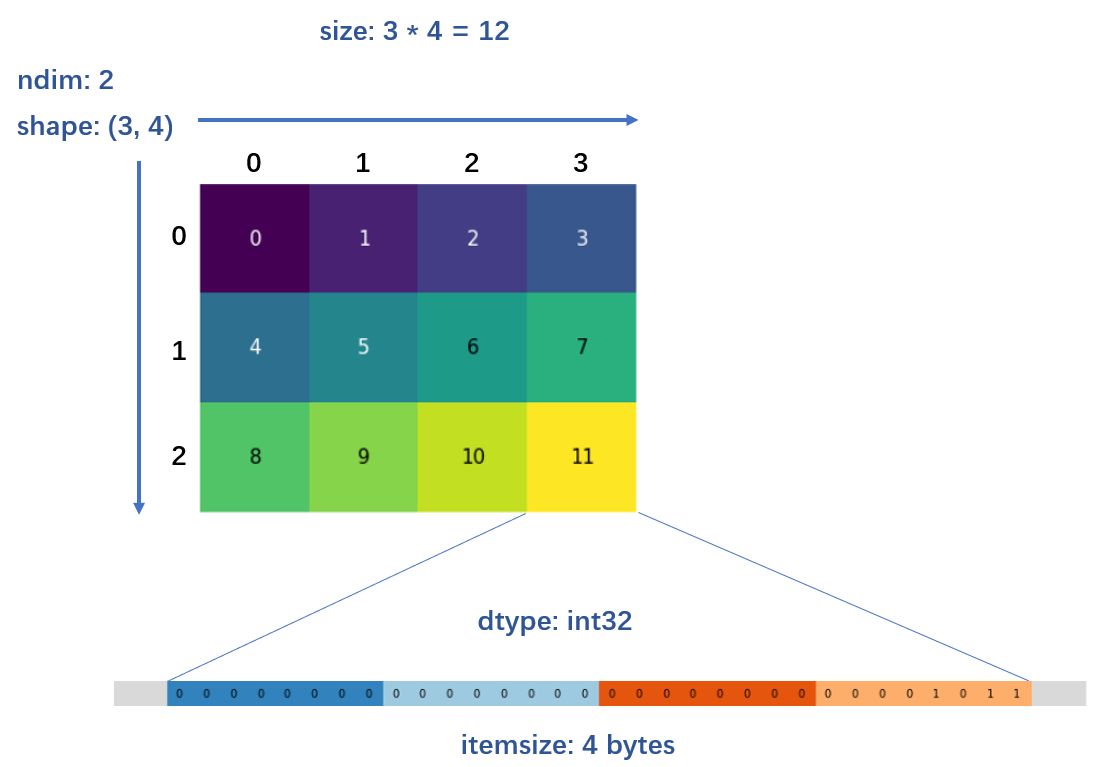
我们以一个3 * 4的矩阵来说明:
array = np.array([[0, 1, 2, 3],
                 [4, 5, 6, 7],
                 [8, 9, 10, 11]], dtype=np.int32)
array
</center>
 </center>
注: 由于是
Little-endian, 实际上该数字在内存中的字节顺序是反序。
ndarray.ndim表示多维数组的维度数目或轴数,对于矩阵而言,其有两个轴,可以理解为成坐标轴的形式,第一个轴表示不同行,第二个轴表示不同列
array.ndim
ndarray.shape表示多维数组的大小,是一个整数元组,期内各个值分别表示不同轴的长度。对array这个二维数组而言,类似于一个2行3列的矩阵。
array.shape
ndarray.size多维数组的元素总数,等于shape中各个值得乘积。
array.size # 2行3列的矩阵自然有8个元素
ndarray.dtype用于描述数组中元素类型的对象。可以在np.array()构造函数或其他创建ndarray的函数中指定元素的类型。
注:
np.ndarray与list的一个主要的区别就是:ndarray是固定元素类型、元素数量的,而list可以动态的增减元素。
array.dtype
ndarray.itemsize表示数组中每个元素所占用的字节数
array.itemsize # 元素类型为float32, 所以占用 4 bytes = 32 bits / 8 bits
上面我们看到了ndarray的抽象表现形式以及基本的属性,现在我们来看看如何创建一个ndarray, 下面将介绍一些比较常用的方法。
1.2 从现成的数据生成ndarray
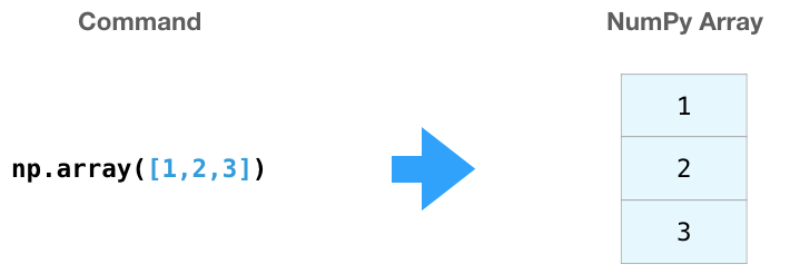
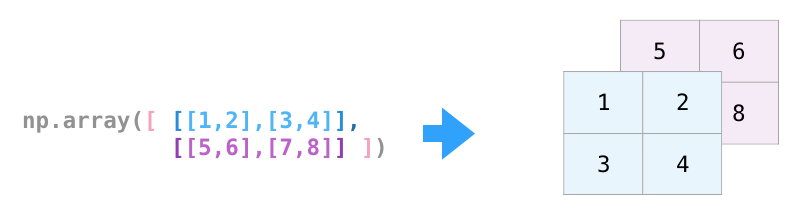
np.array()上面已经用到过这个函数了,可以根据存在python内置的数据类型比如list中的数据,创建一个ndarray。其中的dtype参数可以使用如floatintdouble等标准python类型,也可以使用numpy提供的np.int32np.int16np.float64等对象。
注:数据对象必须作为第一个参数传入, 多维数组需要使用嵌套的数组(或tuple, range)
array = np.array([[1, 2, 3, 4],
                 [4, 5, 6, 7]], dtype=np.float64)    # 如果没有特别的要求,numpy会自动选择合适的dtype
array.dtype
array
np.copy()或ndarray.copy()返回一个已有的ndarray的拷贝
array.copy()
1.3 生成指定大小和元素类型的ndarray。
前面说过,由于ndarray不能动态的删减元素(删减元素需要重新生成相应大小的ndarray, 并拷贝相应的数据,相比于list而言,非常低效),所以使用numpy的时候经常需要使用这些函数创建指定容量的数组(预先分配相应大小的空间,供计算结果使用)。
1.3.1 np.zeros()/np.ones()/np.empty() 用于创建拥有指定大小(shape)和元素类型(dtype)的多维数组,并且使用0/1填充整个数组,即初始化整个数组。

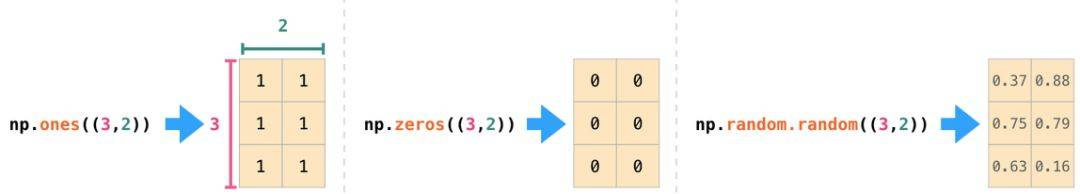

np.empty() 函数生成的数组元素没有初始值,元素的值是随机的,取决于内存的实际状态。
np.empty((2, 2, 3))
还可以指定dtype
np.zeros((3, 4), dtype=np.float)
1.3.2 np.zeros_like()/np.ones_like()/np.empty_like() 在很多计算中,输入数据(数组)和输出数据(数组)的大小是一样的,可以使用这些函数生成与输入数据大小相同,元素类型相同的数组。
new_array1 = np.zeros_like(array)
new_array2 = np.ones_like(array, dtype=np.float64)            # 还可以指定想要的dtype
new_array1.dtype
new_array1
new_array2.dtype
new_array2
1.3.3 np.full/np.full_like 更一般的情况,还可以指定用于填充数组的初始值。
np.full((3, 3), fill_value=3, dtype=np.int)
np.full_like(array, fill_value=4, dtype=np.float)
1.3.4 np.arange()/np.linspace()/np.logspace() 用于创建等差或等比数列(ndarray)。
1.3.4.1 np.arange() 用于创建等差数列,用法和功能和python的built-in函数range相似,只不过这个函数返回的是ndarray。
再次提醒:
[start, stop)为一个左闭右开的区间(不包括stop),返回的数列为间距为step的等差数列。
np.arange(10)         # 等价于 np.arange(start=0, stop=10, step=1)
np.arange(5, 10, 2)   # 等价于 np.arange(start=5, stop=10, step=2)
1.3.4.2 np.linspace(start, stop, num=50, endpoint=True, retstep=False) 也是用于创建等差数列,不过用法要稍微复杂点。其中restep设为True则返回的结果是一个元组,第一个元素还是等差数列(ndarray), 第二个元素则是等差数列的step。我们来看下面的例子:
x1, step1 = np.linspace(2, 10, 4, endpoint=True, retstep=True)
x2, step2 = np.linspace(2, 10, 4, endpoint=False, retstep=True)
plot_linspace(x1, x2, 4)
x1, step1
x2, step2

可以看到,等差数列第一个元素都是start(那是肯定的),关键就在于返回的等差数列的间距step不同。
- 如果
endpoint设为True, 表示返回的等差数列的最后一个元素是stop。等差数列首元素和末元素都已经确定,而等差数列总数为4,中间还需要插入2个点, 则step为:$$\left(10 - 2\right) / \left(2 + 1\right) = 2.666$$ - 如果
endpoint设为False, 则只有首元素是确定的,而等差数列总数为4,中间还需要插入3个点,则step为: $$\left(10 - 2\right) / \left(3 + 1\right) = 2$$ - 知道了
step、首元素start和元素数量,自然就可以计算求出整个等差数列了。
1.3.4.3 np.logspace() 函数生成的是等比数列, 使用方法和np.linspace一样。唯一的不同是该函数需要指定一个指数(默认为10)。
x1 = np.logspace(2, 6, 4, endpoint=True, base=2)
x2 = np.logspace(2, 6, 4, endpoint=False, base=2)
plot_linspace(x1, x2, 4, figsize=(10, 2))
x1
x2

如果说np.linspace()返回的是[start, stop)之间的等差数列,那么np.logspace()返回的就是[base**start, base**stop)之间的等比数列。比值就是上面的例子中计算出来的step。下面的例子展示了他们之间的关联:
x1 = np.linspace(2, 6, 4, endpoint=True)          # 注意使用的是 linspace
x2 = np.linspace(2, 6, 4, endpoint=False)         # 注意使用的是 linspace
plot_linspace(np.power(2, x1), np.power(2, x2), 4, figsize=(10, 2))     # np.power(base, exponents) 为幂函数
x1
x2
可以看到,两种方式是等价的。
2 索引
ndarray支持python中x[obj]的索引语法。根据obj类型的不同,可以分为三大类。基本索引、高级索引和字段访问。这一节介绍基本索引这种与python内置序列索引方式相似的索引模式。
基本索引
在这种索引模式下,obj可以是整数(integer),slice对象(start: stop : step), 或是一个元组, 这元组中包含integer或是slice对象。
注意:
x[(exp1, exp2, ...expN)]是与x[exp1, exp2, ...exp3]是等价的。所以后续都采用x[exp1, exp2, ...exp3]这种方式进行说明。
一维数组的索引方式和list等内置类型几乎没有区别。
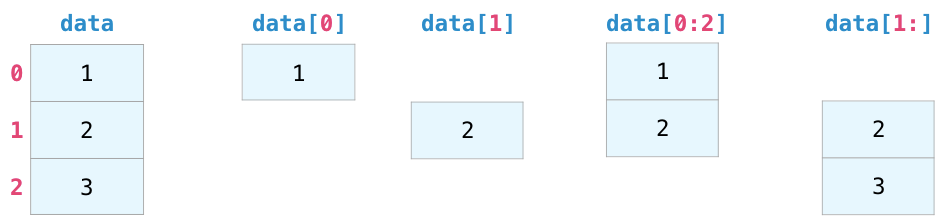
array = np.arange(0, 15, 2)
array
array[2]                                 # 索引
array[2:7:2]                             # 切片,step为 2
array[3:6] = -4                          # 切片,并赋值
array[::-2]                              # 反序切片, step为-2
for i in array[::-1]:                    # 切片, 并迭代
    print(i)
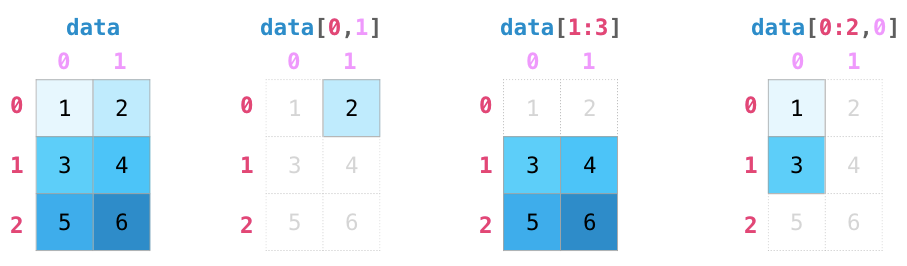
这些操作可以被泛化到多(N)维数组中,即将操作细分到每一个维度(轴)上进行。对多维数组不同轴的整数索引/切片需要用','进行分隔x[obj1, obj2,..,objN],obj可以是integer或者slice。
a = np.array([[ 0,  1,  2,  3],
          [ 4,  5,  6,  7],
          [ 8,  9, 10, 11],
          [12, 13, 14, 15]])
a
a[:, 1]           # 第一个轴完整切片,表示取所有行,第二个轴使用索引1,表示取第二列,返回的是长度为5的一维数组
a[0:5, 1]         # 与上面等价
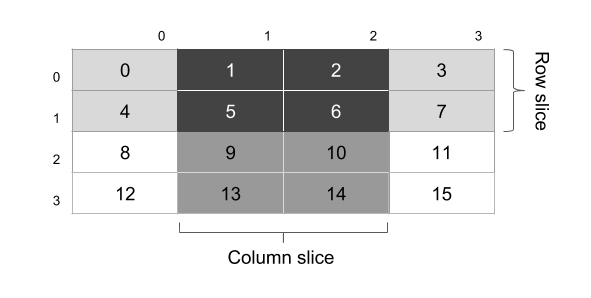
a[0: 2, 1:3]
可以理解为先通过行切片取出前两行,后再通过列切片取出前两行中间的两列
对多维数组进行整数索引/切片的时候需要注意两种方式的区别:对某个轴进行整数索引后返回的数组轴数减少1,使用切片则能保持轴数不变。如:
a = np.random.randn(5, 5)
a[1,:].shape, a[1, :]       # 虽然两语句都是为了取出第2行,但是使用索引会使得二维数组变为一维数组
a[1:2, :].shape, a[1:2, :]
可以省略后面多个轴的索引/切片,缺失的索引/切片将会被视为完整的切片,即:
a[1:2]             # 可以省略后面轴的索引/切片, 取出下标为1的那行
a[1:2, :]          # 这两种方式时等价的
b = np.random.randn(2,2,2)# 注意和一般生成数组的方式不同,这里以多个位置参数的方式指定轴数和各轴的长度
b
b[1:2, 1]          # 省略最后一个轴的索引/切片
b[1:2]             # 省略最后两个轴的索引/切片
还可以用...来表示尽可能多的轴的完整切片。比如一个五维的数组a:
a[1, 2,...]等价于a[1, 2, :, :, :]a[..., 3]等价于a[:, :, :, :, 3]a[1, ...,3, :]等价于a[1, :, :, 3, :]
使用基本索引取得的数组并不拥有真正的数据,只是引用了被索引数组中的数据, 并没有拷贝数据并生成新的数组。所以,对基本索引得到的数组的任何操作实际上都是在原始数组中的数据上进行,以赋值为例:
注:
nunpy的很多操作都是返回这种数组(并不拥有于数据,只是引用其他对象的数据),这种数组也称为view,后续会介绍。
a = np.arange(25).reshape(5, 5)
a
indexed = a[1:4, 1:4]
indexed[:] = 0
indexed
a
a[1:4, 1:4] =0          # 简化操作,不保存中间变量
a = 0                   # 注意这是把0值赋给了a变量,相当于修改了a变量引用的对象。
a                       # 修改一个对象的内部属性,只能通过调用该对象提供的方法,这里索引操作类似于调用对象的一个方法。
可以看到通过修改indexed数组的值,修改了原始数组的值。
迭代
对多维数组的迭代是针对第一个维度(轴)进行的,使用flat属性可以对所有元素进行迭代。
a = np.array([[1, 2, 3, 4],
            [4, 5, 6, 7]])
for row in a:
    row
for i in a.flat:
    i
注意: 对
ndarray进行迭代,效率很低,一般只会对长度较短的轴进行迭代。
3 数组转换
3.1 改变数组的形状
很多时候,某些矩阵运算、机器学习模型的输入数据都需要具有特定大小shape的数组,这时候就需要更改我们数据的维度,以满足计算的要求。比如:
- 将一个数组进行转置以便和其他矩阵进行点乘操作(矩阵的乘法)。
- 将一个一维数组转成形状为
(n_samples, n_features)的二维矩阵。
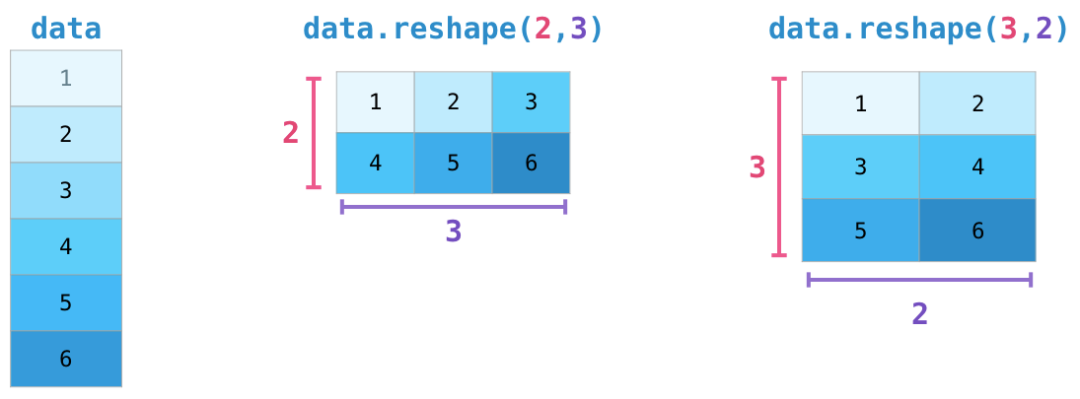
ndarray.reshape() 函数接受一个表示shape的元组或int(变成一维)参数,返回一个具有新shape的数组。reshape()函数不会改变原数组对象,如果可能的话返回一个view, 否则也是返回新数组的copy
a = np.arange(1, 7)
a
a.reshape(2, 3)
a.reshape(3, 2)
使用-1让numpy自动判断剩余的维数大小。
a = np.ones((4, 3))
a
a.reshape(3, -1)
ndarray.resize()函数同样可以修改数组的shape, 但是该函数是直接对原数组进行更改, 并且返回的是None。
a = np.arange(1, 7).reshape(2, 3)
a
print(a.resize(6))
a
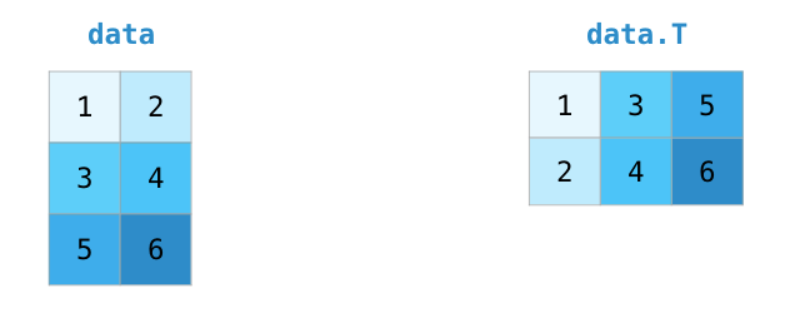
ndarray.T 返回一个数组的转置(Transposition):
a = np.random.randn(3, 4)
a
a.T
ndarray.ravel() 返回一个包含原数组所有元素的一维数组。
a.ravel()
a.ravel().shape
3.2 拼接、拆分数组
除了需要改变数组的形状,有时我们还需要将多个数据(数组)拼接起来或拆分开,比如下面几种情形:
- 在使用机器学习模型的时候,如果有多批训练数据:
n * (n_samples, n_features),为了将所有数据一次性的送给模型,就需要将这些数据一个一个堆叠起来,变成(n * n_sample, n_features)一个完整的ndarray。 - 而有些模型的训练过程,需要分批次的输送数据,这时候就需要将我们的训练样本拆分成多个长度相同的子数组。
numpy的矩阵运算速度非常快,所以将多个数据合并成一个ndarray后再进行计算,能够使得计算速度最大化。
np.concatenate() 接收一个ndarray的元组和一个axis参数, 将多个ndarray沿方向axis(轴)拼接起来。

a = np.zeros((2,2))
b = np.ones((2, 2))
a
b
np.concatenate((a, b), axis=0)            # 沿垂直方向拼接
np.concatenate((a, b), axis=1)            # 沿水平方向拼接
np.hstack() 与np.vstack() 功能与np.concanate()功能类似,只不过不需要指定axis了:
vstack()等价于axis=0,即在垂直(vertical/第一个轴)方向上拼接。hstack()等价于axis=1, 即在水平(horizontal/第二个轴)方向上拼接。
a = np.zeros((2,2))
b = np.ones((2, 2))
a
b
np.vstack((a, b))
np.hstack((a, b))
np.split() 从函数的字面意思就可以猜到,这个函数执行与拼接相反的操作,即将一个数组拆分为多个子数组。
- 函数接受的第二个参数指定拆分的方式,这里为展示使用一个
integer为参数,表明均匀拆分。 - 函数接受的第三个参数为
axis, 可知与上面的拼接一样,指示沿着哪个轴进行拆分。
a = np.ones((3, 4))
a
np.split(a, 2, axis=1) # 第二个参数指定子数组的数目为2,axis参数指定沿着第二个轴进行拆分
np.split(a, 3, axis=0) # 第二个参数指定子数组的数目为3,axis参数指定沿着第一个轴进行拆分
4 计算
numpy支持你能想到的任何基本数学运算。
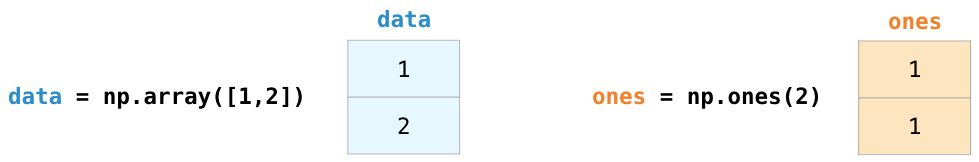
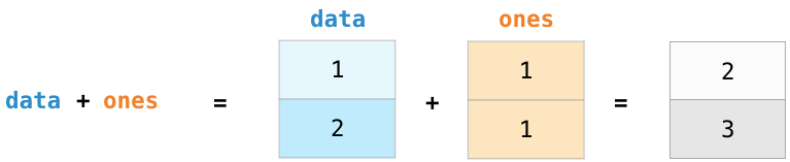
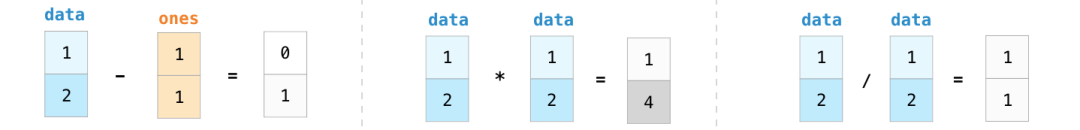
numpy数组的乘/除法运算,可能和我们想象中的不一样(矩阵乘法), 其是element-wise的乘法运算,就和普通的加减乘除一样 :
- 即将两个数组中相对应位置的元素进行相乘。(后面我们会提到矩阵的乘/除运算如何进行)
4.2 广播
可以看到,为了实现element-wise的运算,两个数组的形状大小必须一致。但实际的矩阵运算中,使用一个标量乘以一个矩阵是很常见的操作,numpy支持这种运算吗:
a = np.ones((5, 5))
a
a * 100
结果符合我们的预期,但是其实numpy偷偷的帮你做了另一件事:
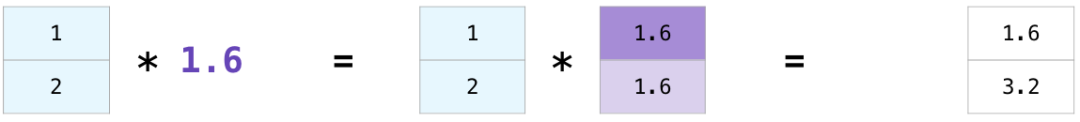
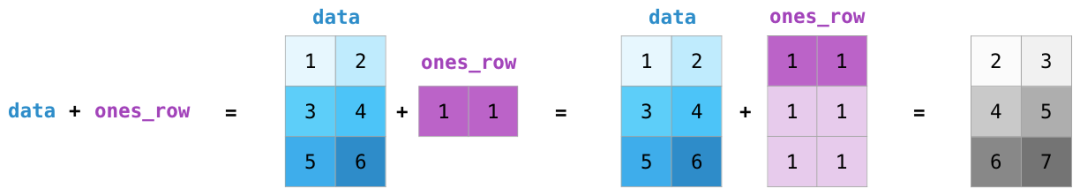
看到了吗,当操作符两边的的运算数组形状不一致的话,numpy会自动的帮你补齐,使得两数组形状一致。这也称为广播,后续的比较操作符, 以及整数数组索引等操作都会在必要的时候帮你自动补齐。
4.3 比较操作符
python 内置的数值类型拥有比较操作符(或谓词),可以返回一个布尔值,numpy的ndarray也可以,因为从抽象的角度来看,对数学运算来说,两个数进行计算/比较和两个数组进行计算/比较没有区别。
如果你理解了上面说的话后,下面的计算结果就显得再自然不过了:
a = np.array([[1, 2, 3, 4],
            [2, 1, 1 ,4],
            [5, 3, 2, 2],
            [6, 2, 43, 1]])
a
a > 5
a != 1
a == 2
甚至,你可以将布尔值的逻辑运算也也拓展到数组这一层面, 不过与python 的 and or not等逻辑运算符不同, 布尔数组 使用与位运算 相似的操作符:
~表取反 类似于not|表按位或 类似于or&表按位与 类似于and- 还有其他的操作符请见
numpy官网(不过其他的操作都可以由上述三个操作进行组合以实现)
a > 5
~(a > 5)
(a > 5) | (a < 2)
(a != 1) & (a < 5)
还有专门针对布尔数组的逻辑运算函数(实际上和python内置的any all 函数类似):
np.all()布尔数组中所有值都为True才返回True, 否则返回Falsenp.any()布尔数组中只要存在一个值为True的就返回True, 否则返回False
a != 0
np.all(a != 0)
a == 43
np.any(a == 43)
4.1 基本统计方法
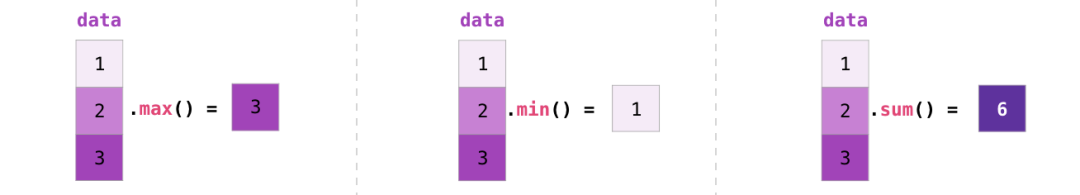
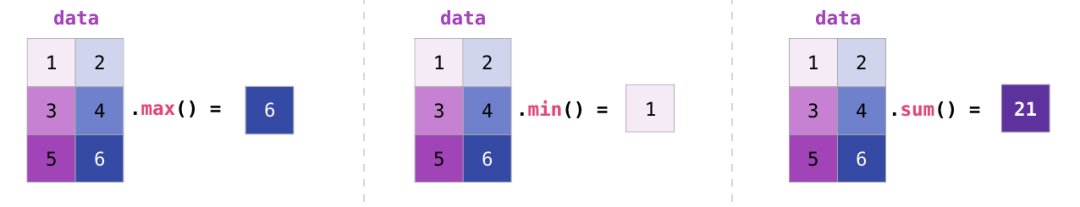
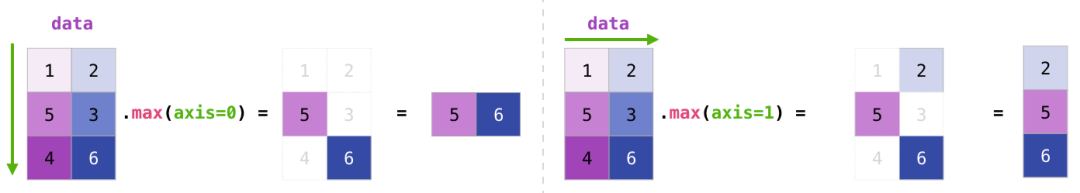
Numpy提供大量的统计函数,比如求均值,最大值,和,方差等等。
4.4 基本线性代数函数
np.dot(a, b) 即点乘,其功能就是进行矩阵的乘法运算。在python3.5+的numpy中可以使用a @ b进行代替。
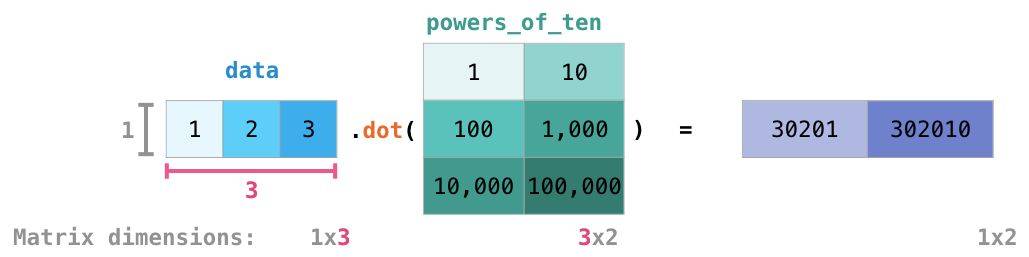
np.linalg.inv() 返回一个可逆矩阵的逆矩阵。$$ A \times B = B \times A = E$$
a = np.array([[1, 2, 3],
             [2, 5, 6],
             [1, 3, 2]])
a
np.linalg.inv(a)
"A * B"
a @np.linalg.inv(a)
"B * A"
np.linalg.inv(a) @ a
np.corrcoef() 可以计算一个多维数组的相关系数矩阵cov。
比如我们有多个样本的基因表达量矩阵, 每行代表每个样本,每列代表每个基因。我们可以计算一下样本间的相关性矩阵:
expression =  np.array([[1, 5, 25, 4, 7, 9, 4, 5, 4, 7],
                      [8, 2, 23, 15, 1, 3, 2, 4, 23, 7],
                      [1, 4, 20, 12, 7, 9, 4, 5, 4, 7],
                      [1, 4, 4, 5, 49, 9, 22, 5, 61, 7],
                      [1, 4, 4, 5, 49, 9, 27, 5, 59, 7]])
np.corrcoef(expression)
plt.figure(); plt.imshow(np.corrcoef(expression), cmap='bwr');plt.colorbar();plt.axis('off')

可以看到,默认是把每一行当作是一个变量, 把该行上每一列的值当作观测值,而计算得到的的cov矩阵。如果想得到各个基因间的相关性,最简单的方法就是转置一下(其实有参数可以指定把行还是列当作变量)。
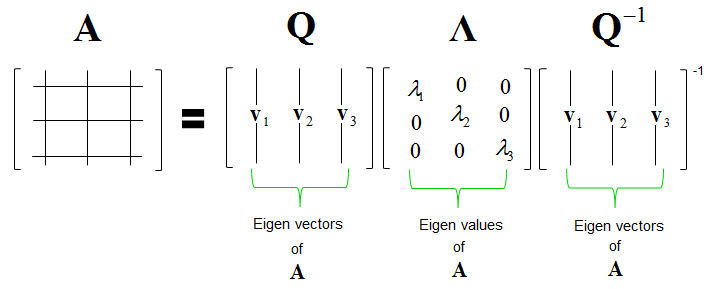
np.linalg.eig() 这个函数对输入的矩阵(方阵)进行特征值分解,返回一个包含特征值向量和特征向量矩阵的元组。
注: 特征向量矩阵每列为一个特征向量进行表示
a = np.array([[1, 2, 3],
             [4, 5, 6],
             [7, 8, 9]])
"A matrix:"
a
eigs, eigvs = np.linalg.eig(a)
eigs, eigvs = np.real(eigs), np.real(eigvs)
'eigen values:'
eigs
'eigen vectors:'
eigvs
"Q * tri_eigs * Q-1:"
(eigvs @ np.diagflat(eigs)) @ np.linalg.inv(eigvs)# 使用inv求矩阵的逆, 如果矩阵是实对称阵,可直接使用转置:eigvs.T
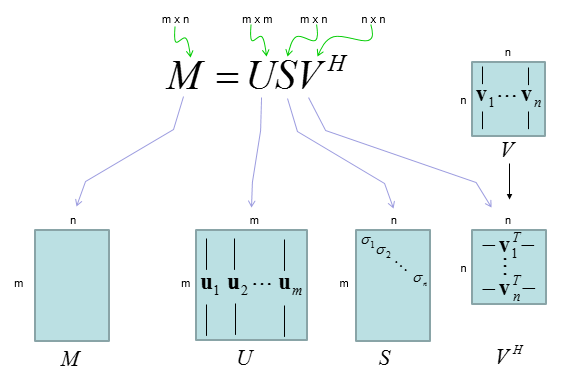
np.linalg.svd() 这个函数则是对矩阵(对形状无要求)进行奇异值分解。由下图可知函数返回一个包含三个ndarray的元组。
a = np.array([[1, 2, 3],
             [4, 5, 6]])
"M:"
a
U, s, Vh = np.linalg.svd(a)
"U:"
U
"disgonal of S:"
s
'Vh:'
Vh
S = np.diagflat(np.concatenate((s, [0])))[:2]
S
" U * S * Vh:"
(U @ S) @ Vh
numpy的linalg模块还有更多关于线性代数的函数,这里仅仅展示了一小部分,详见numpy.linalg。
5 高级索引(使用整数数组和布尔数组进行索引)
Numpy还提供比常规python序列更强大的索引功能,即通过整数数组和布尔数组进行索引,这种索引方式可以极大的提高我们操控数组的灵活性。
5.1 整数数组索引
整数数组索引的方式与一般的索引所表达的意思一样,就是在各个轴上进行索引,并且不同轴的索引使用逗号,进行分隔。与一般索引不同的是,x[obj1, obj2...,objN]中的obj是整数ndarray。下面举两个例子:
通过使用一个二维(palette行索引)数组对palette的第一个轴进行索引,可以获得一个彩色图片(高, 宽,三种色彩)-即三维数组。
palette = np.array( [ [0,0,0],                # black
                       [255,0,0],              # red
                       [0,255,0],              # green
                       [0,0,255],              # blue
                       [255,255,255] ] )       # white
image = np.array( [ [ 0, 1, 3, 4 ],           # each value corresponds to a color in the palette
                    [ 4, 3, 2, 0 ]  ] )
"palette:", palette.shape
palette
'image:', image.shape
image
"Index pallete with image", palette[image].shape
palette[image]                               # the (2,4,3) color image
plt.figure(figsize=(5,2));plt.imshow(palette[image])

因为只对第一个轴进行索引(只有一个ndarray), 所以索引数组中的每个元素值为行索引,通过每个元素值(行索引)取得相对应的行,每一行的shape为(3), 所以最后索引得到的结果的形状为(2, 4, 3)(索引数组形状为(2, 4))。
有的时候,通过某些筛选条件,已经知道了符合条件的元素的行索引和列索引, 这种情况下就可以利用整数数组索引同时对目标数组的两个轴进行索引:
a = np.arange(25).reshape(5, 5)
a
target_x = np.array([0, 1, 2, 3, 4, 0, 1, 2, 3, 4])
target_y = np.array([0, 1, 2, 3, 4, 4, 3, 2, 1, 0])
a[target_x, target_y]
可以看到,我们为了取出两个对角线上的元素,将每个元素的行和列索引分别放在两个索引数组中,索引得到的是一个一维数组。
- 通过第一个数组中的行索引,取得的是
a数组中的某一行(shape为(5,)) - 再通过第二个数组中的列索引取得该行中的某一个值(一个值是0维),所以最后取得的数组形状没有发生改变。
我们前面介绍过的np.where()函数正好可以返回一个包含行索引和列索引数组的元组: (x_indices, y_indices):
a = np.arange(25).reshape(5, 5)
a
x, y = np.where(a > 12)
x, y
a[x, y]
如果对多个轴进行整数数组索引,各个索引数组的shape必须一致(思考下这是为什么?)。
注:实际上很多情况下都不必遵守这个规则,因为有
广播这一特性,numpy会自动的为我们调整数组的形状以满足这个规则。
来看一个例子:
a = np.array([[1, 2, 3, 4],
             [3, 4, 5, 6],
             [6, 7, 8, 9],
             [9, 10, 11, 12]])
a
我们如果想取出由第2、4行,第1、3列元素组成的数组, 可以使用整数数组索引的方式获取:
x_ind =[[1, 1],
        [3, 3]]
y_ind = [[0, 2],
         [0, 2]]
a[x_ind, y_ind]
可以简化为:
x_ind = [[1],
         [3]]
y_ind = [0, 2]
a[x_ind, y_ind]
看到了吗,因为它们的shape不一致,numpy自动的为我们给补全了。
5.2 布尔数组(mask)索引
通过这个名字很容易猜出,这种索引方式不是通过索引值(行/列的下标)进行索引数组,而是通过布尔值,决定保留哪些值(舍弃哪些值)。当用于索引的对象obj为布尔数组(ndarray)则会触发布尔数组索引。
布尔值:
True/False布尔数组:ndarray的dtype为np.bool
由于布尔数组中每个元素的布尔值决定了是否保留被索引数组中相对应位置的元素。可以很自然的想到使用一个和被索引数组形状相同的数组进行索引。这种情况下以一维数组的形式返回所有保留下来(True)的元素。
下面的例子中我想要提取出数组中不等于1的元素, 为了得到我所需要的布尔数组 可以使用之前介绍的比较操作符来生成我们需要的布尔数组:
a = np.array([[1, 2,  1, 1],
              [1, 7,  1, 1],
              [1, 11, 1, 13],
              [1, 1,  16, 1]])
mask = a != 1
a
mask
a[mask]
可以看到成功的取得了我们需要的元素的值。
实际上,在一个轴上使用布尔数组索引mask_array,等价于在该轴上使用np.nonzero(mask_array)即整数数组索引。
- 必须要充分认识到这一点,不然有的时候可能会出错。
- 尤其是当同时使用多个布尔数组的时候,如果没理解这点,就会出现意想不到的结果。
举个例子: 下面我们要把A这个数组中的第2、4行,和第1、3列组成的子数组取出来(前面我们成功的使用整数数组索引做到了)。
A = np.array([[1, 2, 3, 4],
             [3, 4, 5, 6],
             [6, 7, 8, 9],
             [9, 10, 11, 12],
             [3, 2, 1, 3]])
A
mask_array1 = np.array([False, True, False, True, False])
mask_array2 = np.array([True, False, True, False])
mask_array1
mask_array2
在一个轴上使用:
mask_array1的大小一定要与A的第一个轴的长度相等,这很好理解
try:
    A[mask_array2]
except Exception as e:
    print(e)
A[mask_array1]
很好,在意料之中, 让我们把第二个轴的索引也加上去:
A[mask_array1, mask_array2]
欸,好像哪里不对劲,两个轴的索引上各有两个True值啊, 不应该返回一个二维数组吗?
是的,这就是容易出错的地方,违背我们直觉的地方,不过只要按照下面的说法来理解就不会出错了。
- 在索引中使用布尔数组索引
mask_array,等价于使用np.nonzero(mask_array)进行索引,即 使用整数数组索引 - 对于二维数组 使用
np.nonzero()返回一个元组,第一个元素为所有非0元素的行索引组成的一维向量,第二个元素则为所有非0元素的列索引组成的数组。 - 对于一维数组 使用
np.nonzero()还是会返回一个元组,第二个元素为空, 这时只需要第一个有用的元素。
我们来验证下:
还是先来试下只使用第一个mask_array1的情况(如果不能适应最简单的情况,那这说法肯定就是错的了):
np.nonzero(mask_array1)[0]
A[np.nonzero(mask_array1)[0]]
A[mask_array1]
还不错,确实是这么回事,再来试试之前结果出乎意料的索引方式(同时使用两个布尔数组):
np.nonzero(mask_array1)[0]
np.nonzero(mask_array2)[0]
A[np.nonzero(mask_array1)[0], np.nonzero(mask_array2)[0]]
A[mask_array1, mask_array2]
看,是不是一样的。只要使用上面的说法理解,就可以解释的通了。
再来看我们最开始使用的索引方式(二维布尔数组):
mask = A != 1
mask
x, y = np.nonzero(mask)
x, y
A[np.nonzero(mask)]
A[mask]
bingo! 还是说的通,并且这也解答了为什么当使用一个与被索引数组形状相同的布尔数组进行索引时,返回的是一个一维数组的问题。
5.3 总结
总之,将高级索引与numpy的any(), nonzero() > < != & | |= &=以及where()等一系列函数/操作符(生成indices/mask)相结合,可以很轻松、灵活的取得我们想要的元素。
6 view和copy
7 Matrics和Sparse Matrix(稀疏矩阵)
8 ndarray在内存中的储存方式
首先再次强调ndarray的几个重要Attributes,通过后面的讲解你会对这些属性有更新的认识:
array = np.array([[1, 2, 3, 4], [4, 5, 6, 7]], dtype=np.float32)
array.shape     # 对于n维数组,返回长度为n的元组,表示数组的大小,即数组在各个维度的长度
array.dtype     # 数组每个元素的类型,float32表明每个元素占用4字节-32bit
array.strides   # 见后
8.1 元素在内存中的布局
在了解了ndarray的抽象数据表示(声音序列、图像、矩阵)和一般性操作后,我们来看看ndarray在计算机内存中是怎么表示的呢(当然不可能和抽象表示一样,三维以下还有可能,更高维相像都想不出)。
计算机内存本质上是线性的(一维), 其基本结构是线性排列的一批储存单元,一般一个单元为1byte(8bit),每个单元有其唯一的编号-单元地址,程序通过地址进行访问,存取数据;对于一维数组很好办,按照元素的顺序一个一个排列就行了,对于N维数组呢?
Row Major

Column Major
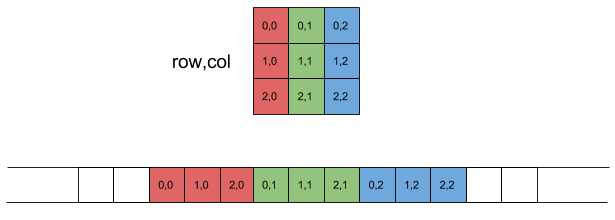
没错,还可以这么线性存储。只要按照一定的规则来存储,就可以通过计算元素所在的地址来访问对应的元素,从而将多维数组的每个元素映射到内存中的某个位置。我们以上图的Row Major存储方式来举例(对于numpy.ndarray 而言, 默认为按行存储):
注:
ndarray与python内置的数据类型如list的最主要的区别就在于元素的存储方式上,list是动态数组,其元素(对象)分散在内存中的各个地方,list对象通过一个引用数组(类似于地址)记录各个元素所在的位置。在进行大量数据计算的时候,numpy.ndarray这种顺序存储的方式能够使得现代CPU对计算进行更多的优化, 这也是numpy速度快的一个原因。详情见下方链接。
可知,第i行第j列的元素在内存中的地址相对于首元素地址的偏移为:$$offset = row \times ncols + col$$
因此知道了首元素的地址和需要访问的元素所在的行和列,就可以通过计算偏移的方式寻找到相应元素的地址了。
我们来看看ndarray中的元素的默认存储顺序:
array = np.array([[1, 2, 3, 4],
                  [4, 5, 6, 7]], dtype=np.int8) # 这里注意选择dtype为int8(每个元素占用一个字节)
raw_bytes = array.tobytes('A')                  # 'A' 表明按照元素储存的顺序输出bytes序列,否都会以Row major的顺序输出元素
" ".join(str(x) for x in raw_bytes)
raw_bytes[1 * 4 + 2]                            # 可以看到这两种方式取出来的值都相同
array[1, 2]
还有Column Major的存储顺序:
array = np.array([[1, 2, 3, 4],
                  [4, 5, 6, 7]],
                 dtype=np.int8, order='F')  # 使用order参数来指定元素在内存种的布局方式,F表示Fortan风格(Column Major)
raw_bytes = array.tobytes('A')
" ".join(str(x) for x in raw_bytes)
raw_bytes[2 * 2 + 1]                        # 可以看到这两种方式取出来的值都相同
array[1, 2]
8.2 shape、dtype和strides
- 现在
shape的作用就显而易见了(用于寻地址)。 dtype也决定着如何寻址。上面的计算地址的公式默认了一个假设,那就是每个元素只占用一个字节, 而1字节最大只能用于表示256(2**8), 所以存储一个正整数一般需要使用4个字节,对于浮点数则需要更多。现在寻址的偏移公式为:$$offset = \left( row \times ncols \times + col \right) \times nbytes$$
strides 中文意思就是步伐
array = np.array([[1, 2, 3, 4], [4, 5, 6, 7]], dtype=np.float32)
array.strides
4 * 4, 1 * 4
- 如果要跨行遍历元素,比如先访问
array[0, 0]后访问array[1, 0]那么需要移动几个字节呢,答案是 4 * 4 = 16字节。 - 如果要跨列遍历元素,比如先访问
array[0,1]后访问array[0,2]呢,那么需要移动4字节(因为在Row Major中同一行的元素是仅靠着的)。 - 所以
strides记录的是在不同维度移动一个单位时所需要的移动的偏移量(步伐)。
8.3 尽可能的使用vectorizing操作
尽可能的使用numpy提供的运算函数或操作符,不要对一个数组进行迭代。
# python 中的基本类型都是对象,所以,你可以很轻松的生成一个值很大的int值: 10000000000000000000000000000000
my_int = 1000000000000000000000000000000000000000000000000000000000000000
my_int
a = np.zeros((10000,))
b = [0]*10000
%timeit -n 50 c = [ i for i in a]
%timeit -n 50 d = [i for i in b ]
# python中的数值都是对象,而numpy中的数值想要提取出来,需要读取每个元素的值(读取字节)并经过一系列操作转换为int(python对象)。
# 所以尽可能的利用numpy所提供的vectorizing方法,让numpy进行计算。